-
MetaTagger
Gli archivi documentali contengono spesso migliaia di PDF salvati con nomi generici, classificati in cartelle differenti o privi delle informazioni necessarie per identificarne rapidamente il contenuto.
Anche quando il testo è già riconoscibile, la ricerca può dipendere dalla conoscenza del nome del file, della cartella corretta o delle parole esatte contenute nel documento.
La classificazione manuale richiede inoltre agli operatori di aprire ogni file, individuarne i dati rilevanti e compilare tag, categorie e campi documentali. Un’attività ripetitiva, lenta e soggetta a errori o criteri non uniformi.
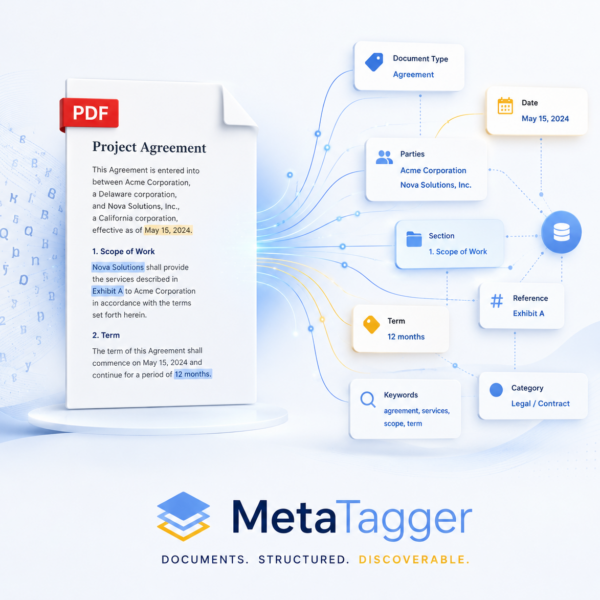
MetaTagger analizza il testo disponibile nei documenti e associa i metadati previsti dalle regole configurate, rendendo i file più facilmente ricercabili, classificabili e utilizzabili nei processi aziendali.
Il sistema trasforma quindi una raccolta di PDF in un archivio documentale più strutturato, nel quale ogni documento può essere riconosciuto attraverso dati e classificazioni coerenti.
-
Scaneye
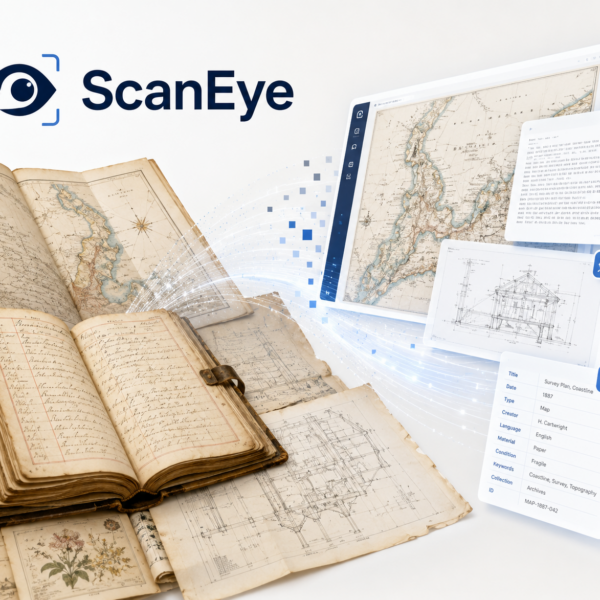
Archivi storici, registri rilegati, documenti fragili, tavole fuori formato e materiali difficili da movimentare non possono essere acquisiti con scanner tradizionali senza rischiare deterioramenti, deformazioni o perdita di qualità.
ScanEye consente di digitalizzare questi materiali attraverso modalità di acquisizione non invasive, evitando sistemi a trascinamento e riducendo la necessità di manipolare ripetutamente gli originali.
Il documento acquisito può essere successivamente elaborato mediante OCR, indicizzazione e metadatazione, trasformando un contenuto fisico difficile da consultare in una risorsa digitale ricercabile, classificabile e più facilmente accessibile.
-
OCRFlow
Molti archivi digitali sono costituiti da PDF generati tramite scansione o immagini che riproducono correttamente il documento, ma non permettono di cercare o selezionare.
In questi casi, individuare una parola, una pratica o un riferimento richiede l’apertura e la lettura manuale di ogni file. Il problema aumenta quando l’archivio comprende centinaia o migliaia di documenti.
OCRFlow applica il riconoscimento ottico dei caratteri ai PDF, individuando il testo presente nelle pagine e rendendolo ricercabile, consultabile ed elaborabile dai sistemi digitali.
Il documento non rimane quindi una semplice immagine: diventa una risorsa utilizzabile all’interno di archivi, procedure documentali e successive attività di indicizzazione o metadatazione.