

Descrizione
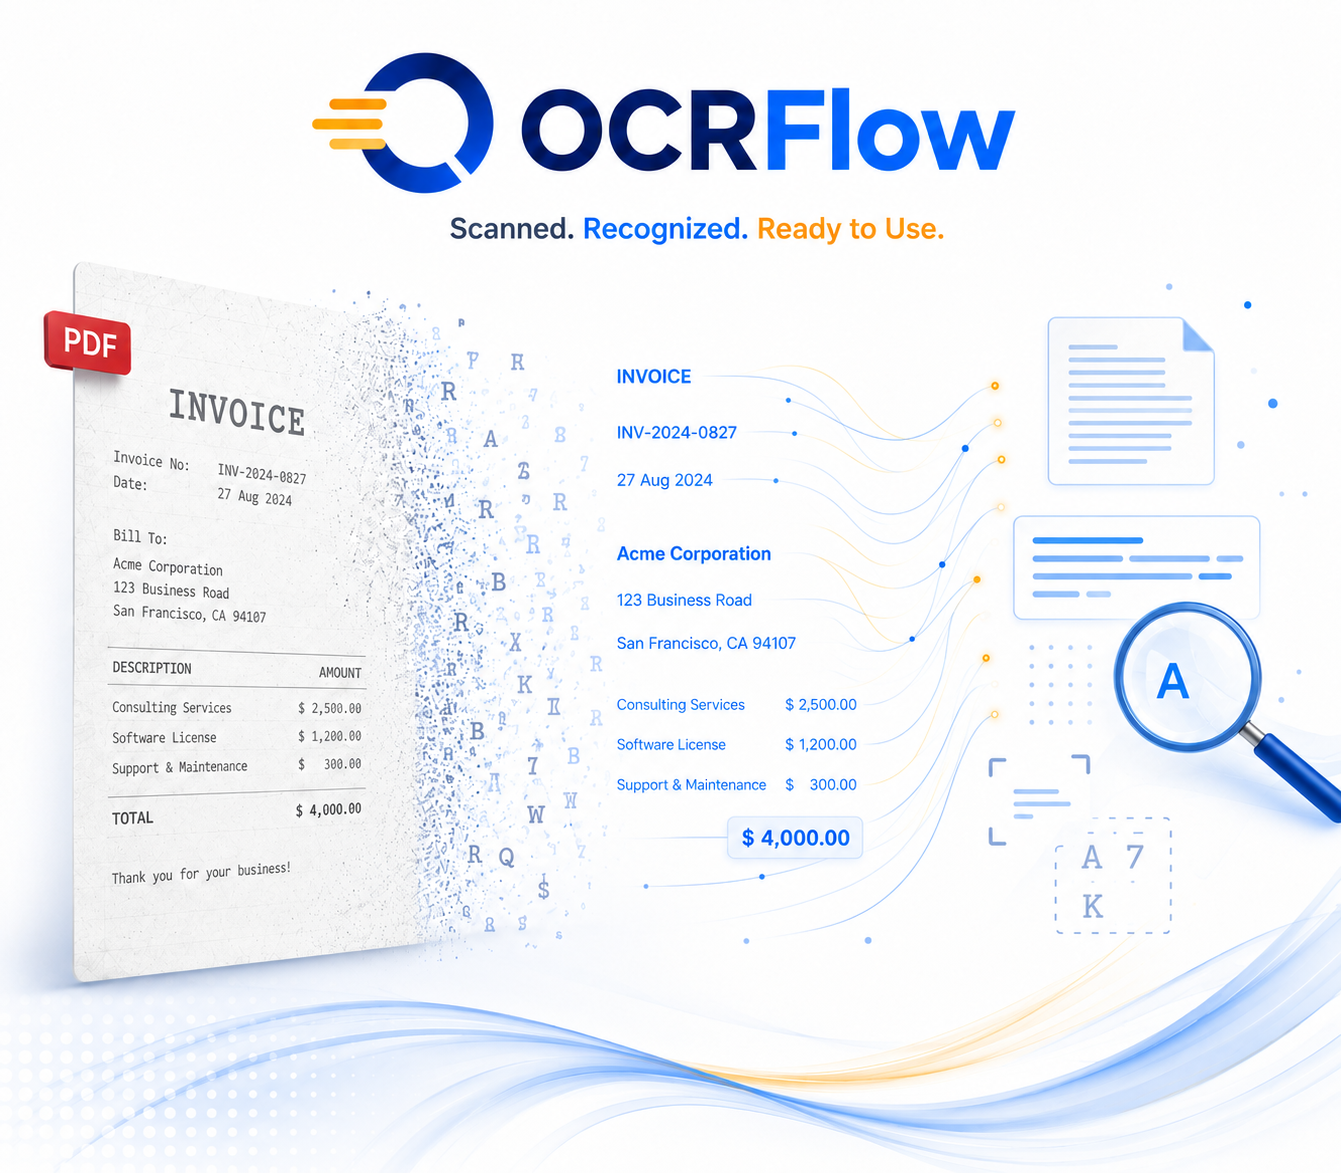
Il sistema analizza le pagine acquisite, individua i caratteri presenti e genera un livello testuale utilizzabile per la ricerca, la consultazione e le successive elaborazioni documentali.
OCRFlow consente di valorizzare archivi che, pur essendo disponibili in formato digitale, si comportano ancora come semplici fotografie del documento originale.
Il testo può essere utilizzato per ricercare parole e riferimenti all’interno dei file, facilitare la consultazione e predisporre i contenuti per ulteriori processi di indicizzazione, classificazione o metadatazione.
La soluzione può essere applicata a singoli documenti o a raccolte più ampie, in funzione dei volumi, dei formati e delle modalità operative definite per il progetto.
La qualità del riconoscimento dipende dalle caratteristiche del documento originale e dell’acquisizione.
OCRFlow supporta il processo di riconoscimento testuale, ma i risultati devono essere verificati quando vengono utilizzati per attività critiche, ufficiali o procedure che richiedono assoluta precisione.


Reviews
There are no reviews yet.